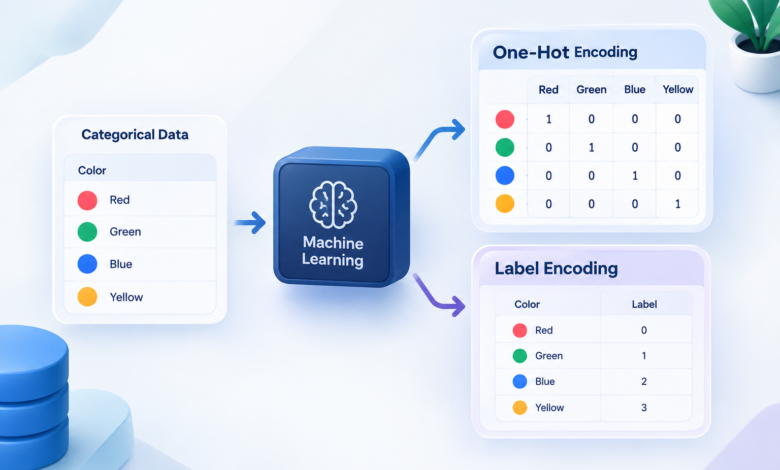
مدلهای یادگیری ماشین میتوانند با اعداد کار کنند اما نه با متن. بیشتر دیتاستهای دنیای واقعی از ویژگیهای دستهای (Categorical) مانند رنگ، کشور یا نوع محصولات خاص تشکیل شدهاند. تبدیل این ویژگیهای غیرعددی به نمایشهای عددی قبل از تغذیه این دادهها به مدل، چالشی میشود. اینجاست که One-Hot Encoding وارد میشود. این تکنیک ساده اما قدرتمند، دادههای دستهای را به قالب عددیای تبدیل میکند که بهراحتی میتوان به مدل داد. آن را مثل آموزش مدلی در نظر بگیرید که «قرمز»، «سبز» و «آبی» متفاوتاند اما مثل ۱ < ۲ < ۳ ترتیبدار نیستند.
نکات کلیدی
- One-Hot Encoding متغیرهای دستهای را به بردارهای باینری تبدیل میکند؛ که برای مدلهای یادگیری ماشین مناسبشان میسازد.
- از تفسیر ترتیبی اشتباه جلوگیری و تضمین میکند هر دسته مستقل و برابر رفتار شود.
- Label Encoding را فقط وقتی استفاده کنید که دستهها ترتیب طبیعی داشته باشند.
- برای دیتاستهای بزرگ، بهینهسازیهایی مانند ماتریسهای اسپارس،
drop='first'و کاهش بعد را اعمال کنید. - مدیریت کارآمد دادههای کدگذاریشده، آموزش سریعتر، مصرف حافظه کمتر و عملکرد بهتر مدل را تضمین میکند.
One-Hot Encoding چیست؟
One-Hot Encoding مقادیر دستهای را به بردارهای باینری تبدیل میکند. هر دسته به ستون جداگانهای تبدیل میشود؛ که ۱ حضور آن دسته و ۰ غیابش را نشان میدهد.
مثال:
| Color | Red | Green | Blue |
|---|---|---|---|
| Red | 1 | 0 | 0 |
| Green | 0 | 1 | 0 |
| Blue | 0 | 0 | 1 |
به این ترتیب، مدل هر دسته را مستقل رفتار میکند و هیچ رابطهای بین آنها فرض نمیکند.
دیتاست اصلی:

بعد از One-Hot Encoding:

چرا از One-Hot Encoding استفاده کنیم؟
همانطور که فهمیدیم، مدل یادگیری ماشین فقط مقادیر عددی را بهعنوان ورودی میپذیرد؛ بنابراین One-Hot Encoding روشی ساده اما قدرتمند برای تبدیل این مقادیر به مقادیر عددی است که بهراحتی میتوانیم به مدلمان بدهیم. دلیل دیگر استفاده از این رویکرد این است که One-Hot Encoding تضمین میکند دادههای دستهای بهراحتی در مدلهایی مانند رگرسیون خطی، رگرسیون لجستیک، درختهای تصمیم و شبکههای عصبی—بدون اعوجاجهای ناشی از تفسیر اشتباه عددی—یکپارچه شوند. تقریباً هر کتابخانه پیشپردازش دادهای مانند Pandas، Scikit-learn و TensorFlow، روشهای داخلی برای One-Hot Encoding فراهم میکند. این تمرین استانداردی در هر پایپلاین یادگیری ماشین است و پایهای برای روشهای کدگذاری پیشرفتهتر مانند Embeddingها میسازد. راه دیگر تبدیل این مقادیر، استفاده از برچسبهای عددی است؛ مثلاً: قرمز = ۱، سبز = ۲، آبی = ۳. این فرایند Label Encoding نامیده میشود.
Label Encoding چیست؟
Label Encoding فرایند تبدیل ویژگیهای دستهای به ویژگیهای عددی (یعنی ۰، ۱، ۲، ۳ و غیره) است. Label Encoding شامل تبدیل هر مقدار در ستونی به عدد است. بگذارید مثالی ببینیم و بیشترش را درک کنیم:

اینجا، اعداد متفاوتی به نامهای شهرهای متفاوت اختصاص یافتهاند؛ برخلاف ستون جداگانه به ازای هر شهر که در One-Hot Encoding انجام دادیم.
تکنیکهایی مانند Label Encoding میتوانند به کاهش تعداد برچسبها کمک کنند؛ اما مسئله جدیای معرفی میکنند: مدل این اعداد را طوری تفسیر میکند که ترتیب یا فاصله ذاتی دارند. ممکن است فرض کند نیویورک (۲) بین لسآنجلس (۱) و سانفرانسیسکو (۳) قرار دارد؛ که برای ویژگی دستهای هیچ منطقی ندارد.
اینجاست که One-Hot Encoding ضروری میشود. با تبدیل هر دسته به ستون جداگانهای با مقادیر باینری (۱ یا ۰)، One-Hot Encoding تضمین میکند هیچ رتبهبندی یا سلسلهمراتب ضمنیای بین دستهها وجود نداشته باشد.
| Color | Red | Green | Blue |
|---|---|---|---|
| Red | 1 | 0 | 0 |
| Green | 0 | 1 | 0 |
| Blue | 0 | 0 | 1 |
اینجا، همه رنگها بهطور متمایز برابر رفتار میشوند؛ که هر فرض اشتباهی از «بزرگتر از» یا «کوچکتر از» را حذف میکند. اگر رنگها را بهصورت عدد کدگذاری کنید:
قرمز = 1، سبز = 2، آبی = 3مدل ممکن است فکر کند آبی > سبز > قرمز. اما با One-Hot Encoding:
قرمز = [1,0,0]، سبز = [0,1,0]، آبی = [0,0,1]مدل هر رنگ را موجودیت جداگانه و مستقلی درک میکند؛ دقیقاً همان چیزی که میخواهیم.
وقتی متغیر دستهای شما ترتیب یا رتبهبندی طبیعی دارد، استفاده از Label Encoding مناسبتر است. Label Encoding به هر دسته مقدار صحیح یکتایی اختصاص میدهد؛ که ترتیب ذاتی بین آنها را حفظ میکند. مثلاً، ویژگی «اندازه» را با دستههای کوچک، متوسط، بزرگ در نظر بگیرید. اینجا، این دستهها ترتیب معناداری دارند: کوچک < متوسط < بزرگ. استفاده از One-Hot Encoding این رابطه را نادیده میگیرد؛ در حالی که Label Encoding آن را مؤثر ثبت میکند.
| Size | Label Encoded |
|---|---|
| Small | 0 |
| Medium | 1 |
| Large | 2 |
در این مورد، Label Encoding به مدل میگوید «بزرگ» از «متوسط» بزرگتر است؛ که منطقی است.
اما Label Encoding فقط باید برای ویژگیهای ترتیبی (Ordinal) استفاده شود؛ نه برای دستههای اسمی (Nominal) مانند رنگ یا کشور که هیچ ترتیب ذاتیای ندارند. استفاده از آن در آن موارد میتواند مدل را گمراه کند تا روابط عددی کاذب تفسیر کند.
One-Hot Encoding در مقابل Label Encoding
| جنبه | One-Hot Encoding | Label Encoding |
|---|---|---|
| نمایش | بردار باینری به ازای هر دسته میسازد | برچسب صحیح به هر دسته اختصاص میدهد |
| رابطه ترتیبی | هیچ: همه دستهها را متمایز و بدونترتیب رفتار میکند | ترتیب طبیعی بین دستهها را حفظ میکند |
| تعداد ویژگیهای ایجادشده | با تعداد دستههای یکتا افزایش مییابد | همیشه یک ویژگی به ازای هر ستون |
| مناسب برای | دادههای دستهای اسمی (بدونترتیب) مانند رنگ، شهر، برند | دادههای دستهای ترتیبی مانند اندازه، امتیاز و سطح تحصیلات |
| تفسیر مدل | تفسیر آسانتر؛ چون دستهها مستقل میمانند | میتواند مدلها را گمراه کند اگر روی دادههای غیرترتیبی استفاده شود |
| مصرف حافظه | بالاتر؛ چون چندین ستون میسازد | پایینتر؛ چون فقط یک ستون به ازای هر ویژگی وجود دارد |
| مثال (رنگها) | قرمز → [1,0,0]، سبز → [0,1,0]، آبی → [0,0,1] | قرمز → 0، سبز → 1، آبی → 2 |
| پشتیبانی توسط | همه فریمورکهای ML (Pandas، Scikit-learn، TensorFlow) | همه فریمورکهای ML (Pandas، Scikit-learn، TensorFlow) |
نحوه انجام One-Hot Encoding (با مثالهای پایتون)
ببینیم چطور One-Hot Encoding را در پایتون اعمال کنیم.
استفاده از Pandas:
import pandas as pd

data = {'Color': ['Red', 'Green', 'Blue', 'Green']}
df = pd.DataFrame(data)

encoded_df = pd.get_dummies(df, columns=['Color'])
print(encoded_df)
خروجی:
   Color_Blue  Color_Green  Color_Red
0           0            0          1
1           0            1          0
2           1            0          0
3           0            1          0
استفاده از Scikit-learn:
from sklearn.preprocessing import OneHotEncoder
import pandas as pd

data = pd.DataFrame({'Color': ['Red', 'Green', 'Blue']})

encoder = OneHotEncoder(sparse=False)
encoded = encoder.fit_transform(data[['Color']])
print(encoded)
خروجی:
[[0. 0. 1.]
 [0. 1. 0.]
 [1. 0. 0.]]
برای پسگرفتن نام ستونها:
print(encoder.get_feature_names_out(['Color']))چه زمانی از One-Hot Encoding استفاده نکنیم
One-Hot Encoding برای دادههای دستهای با کاردینالیتی-پایین (دستههای یکتای کم) عالی کار میکند. اما اگر ستونی صدها یا هزاران مقدار یکتا داشته باشد، کدگذاریاش تعداد عظیمی از ستونها میسازد؛ که به انفجار بعدی منجر میشود؛ که به نفرین بعدیبودن (Curse of Dimensionality) هم معروف است.
در چنین مواردی، از جایگزینهایی مانند اینها استفاده کنید:
- Label Encoding برای دستههای ترتیبی.
- Target Encoding برای پیشبینهای دستهای.
- لایههای Embedding در مدلهای یادگیری عمیق.
مدیریت کارآمد دادههای One-Hot کدگذاریشده
در حالی که One-Hot Encoding تکنیک قدرتمندی برای نمایش متغیرهای دستهای است، میتواند به فضاهای ویژگیِ پربعدی منجر شود؛ بهویژه اگر دیتاستها شامل بسیاری از دستههای یکتا (کاردینالیتی بالا) باشند. این مسئله—که اغلب «نفرین بعدیبودن» نامیده میشود—میتواند مدلها را کندتر، مصرف حافظه را بیشتر و حتی به Overfitting منجر کند.
اینجا چند تکنیک عملی برای مدیریت کارآمدتر دادههای One-Hot کدگذاریشده هست:
۱. استفاده از ماتریسهای اسپارس
وقتی One-Hot Encoding را اعمال میکنید، بیشتر مقادیر تولیدشده صفرند (چون فقط یک موقعیت در هر بردار «Hot» یا ۱ است). بهجای ذخیره صریح همه آن صفرها، میتوانید از نمایش ماتریس اسپارس استفاده کنید تا فقط موقعیتهای عناصر غیرصفر ذخیره شوند. در scikit-learn، این بهینهسازی را با این تنظیم فعال میکنید:
encoder = OneHotEncoder(drop='first', sparse=True)فقط همین یک قدم میتواند مصرف حافظه را برای دیتاستهای بزرگ بهطور چشمگیری کم و محاسبات را سریع کند.
۲. حذف اولین ستون برای جلوگیری از همخطی چندگانه
در مواردی که دستهها مانعةالجمعاند، یکی از ستونها را میتوان بدون از دست دادن اطلاعات حذف کرد. مثلاً، اگر سه رنگ دارید—قرمز، سبز، آبی—دانستن دو تا برای استنباط سومی کافی است. با استفاده از:
OneHotEncoder(drop='first')افزونگی را کم و از همخطی چندگانه (Multicollinearity) جلوگیری میکنید؛ که میتواند با مدلهای خطی مانند رگرسیون خطی یا رگرسیون لجستیک تداخل کند.
۳. ترکیب با تکنیکهای کاهش بعد
وقتی تعداد ویژگیها بهدلیل متغیرهای دستهای زیاد منفجر میشود، کاهش بعد را برای فشردهسازی فضای ویژگی—حفظ بیشتر واریانس—اعمال کنید.
تکنیکهایی مانند تحلیل مؤلفههای اصلی (PCA) یا Autoencoderها معمولاً استفاده میشوند:
- PCA ویژگیهای همبسته را به مجموعه کوچکتری از مؤلفههای همبستهنشده تبدیل میکند.
- Autoencoderها (مبتنی بر شبکه عصبی) نمایشهای کمبعد کارآمد را خودکار یاد میگیرند.
ترکیب اینها با One-Hot Encoding تضمین میکند مدلهایتان از نظر محاسباتی کارآمد بمانند بدون قربانی کردن عملکرد پیشبینی:
from sklearn.preprocessing import OneHotEncoder
from sklearn.decomposition import PCA
from sklearn.pipeline import Pipeline

pipeline = Pipeline([
    ('encoder', OneHotEncoder(sparse=True, drop='first')),
    ('reduce_dim', PCA(n_components=10))
])
مثال عملی: One-Hot Encoding در مدل دستهبندی
بگذارید آن را روی مدلی ساده برای پیشبینی نوع میوه اعمال کنیم:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import OneHotEncoder
import numpy as np

data = pd.DataFrame({
    'Fruit': ['Apple', 'Banana', 'Mango', 'Banana', 'Apple'],
    'Weight': [150, 120, 200, 130, 160],
    'Label': [1, 0, 1, 0, 1]
})

X = data[['Fruit', 'Weight']]
y = data['Label']

encoder = OneHotEncoder(drop='first', sparse=False)
encoded = encoder.fit_transform(X[['Fruit']])

X_final = np.concatenate([encoded, X[['Weight']].values], axis=1)

model = LogisticRegression()
model.fit(X_final, y)
print("Model trained successfully!")
سوالات متداول
۱. هدف اصلی One-Hot Encoding چیست؟
One-Hot Encoding متغیرهای دستهای را به ماتریس باینری تبدیل میکند تا مدلهای یادگیری ماشین بتوانند آنها را بدون دلالت به هیچ رابطه ترتیبی، عددی تفسیر کنند. این تضمین میکند هر دسته متمایز و مستقل رفتار شود.
۲. چه زمانی باید بهجای One-Hot Encoding از Label Encoding استفاده کنم؟
وقتی متغیر دستهایتان ترتیب طبیعی دارد (مثلاً «کم»، «متوسط»، «زیاد») از Label Encoding استفاده کنید. به دستهها مقادیر صحیح اختصاص میدهد و رتبهشان را حفظ میکند. اما برای دستههای غیرترتیبی (مثل رنگها یا نام شهرها)، One-Hot Encoding انتخاب بهتری است تا از فرضهای ترتیبی کاذب جلوگیری شود.
۳. چرا One-Hot Encoding باعث بعدیبودن بالا میشود؟
هر دسته یکتا، ستون باینری جدیدی تولید میکند. برای دیتاستهایی با صدها یا هزاران مقدار یکتا، این فضای ویژگی عظیمی میسازد؛ که به ناکارآمدی حافظه و آموزش کندتر منجر میشود. ماتریسهای اسپارس و کاهش بعد به کاهش این مسئله کمک میکنند.
۴. آیا میتوان از One-Hot Encoding برای دادههای متنی استفاده کرد؟
نه مستقیم. One-Hot Encoding برای دادههای دستهای ساختاریافته ایدهآل است. برای دادههای متنی، تکنیکهایی مانند Bag of Words، TF-IDF یا Embeddingهای کلمه (Word2Vec، BERT) مؤثرترند؛ چون روابط معنایی را ثبت میکنند.
۵. چطور از همخطی چندگانه در ویژگیهای One-Hot کدگذاریشده جلوگیری کنم؟
میتوانید از پارامتر drop='first' در OneHotEncoder برای حذف یک ستون به ازای هر ویژگی استفاده کنید. این از افزونگی بدون از دست دادن اطلاعات اجتناب میکند و بهویژه برای مدلهای خطی مفید است.
۶. آیا One-Hot Encoding بر عملکرد مدل اثر میگذارد؟
به دیتاست و مدل بستگی دارد. در حالی که تفسیرپذیری دادههای دستهای را بهبود میبخشد، اگر بهینه نشود میتواند آموزش را کند کند. مدلهای مبتنی بر درخت (مثل XGBoost یا جنگلهای تصادفی) گاهی میتوانند دادههای دستهای را مستقیم مدیریت کنند؛ که نیاز به One-Hot Encoding کامل را کم میکند.
نتیجهگیری
در این مقاله فهمیدیم چگونه تکنیکی ساده اما قدرتمند میتواند دادههای دستهای شما را به قالبی تبدیل کند که بهراحتی میتوان به مدل یادگیری ماشین داد. One-Hot Encoding مسئله اختصاص مقادیر عددی دلخواه که میتواند الگوریتمها را گمراه کند را با تبدیل دستهها به بردارهای باینری حذف میکند. اما همچنین یاد گرفتیم که در حالی که تفسیرپذیری و دقت مدل را ارتقا میبخشد، میتواند به دادههای پربعدی هم منجر شود؛ بهویژه با ویژگیهایی حاوی بسیاری از دستههای یکتا.
برای مدیریت کارآمد این، تکنیکهایی مانند استفاده از ماتریسهای اسپارس، حذف ستونهای افزونه یا اعمال روشهای کاهش بعد مانند PCA ارزشمند میتوانند باشند. درک اینکه کِی و چطور از One-Hot Encoding—بههمراه محدودیتهایش—استفاده کنیم، به متخصصان داده اجازه میدهد دیتاستهای تمیزتر و کارآمدتری بسازند و مدلهایی بسازند که تعمیم بهتری داشته باشند.
تسلط بر این تکنیکهای ساده اما مؤثر، قدم بنیادی بهسوی آمادهسازی دادههای باکیفیت است؛ که مستقیماً بر موفقیت هر پروژه یادگیری ماشین اثر میگذارد.